Perkembangan kecerdasan buatan (AI) di bidang Pemrosesan Bahasa Alami atau Natural Language Processing (NLP) telah mengubah cara manusia berinteraksi lintas bahasa. Fitur penerjemahan suara secara langsung (real-time speech translation) kini menjadi salah satu inovasi teknologi yang paling banyak diterapkan dalam aplikasi komunikasi maupun platform pendidikan digital.
Sistem ini tidak sekadar mengonversi kata demi kata dari satu bahasa ke bahasa lain. Di balik layar, terdapat integrasi kompleks antara pemrosesan sinyal audio, pemodelan konteks bahasa, dan sintesis suara otomatis. Memahami cara kerja teknologi ini memberikan gambaran jelas mengenai bagaimana AI memproses data linguistik serta bagaimana inovasi tersebut dapat dimanfaatkan secara optimal dalam proses pembelajaran.
Tiga Arsitektur Utama dalam Terjemahan Suara Real-Time
Sistem terjemahan suara real-time berbasis kecerdasan buatan umumnya mengandalkan alur kerja yang terdiri dari tiga komponen utama:
1. Automatic Speech Recognition (ASR)
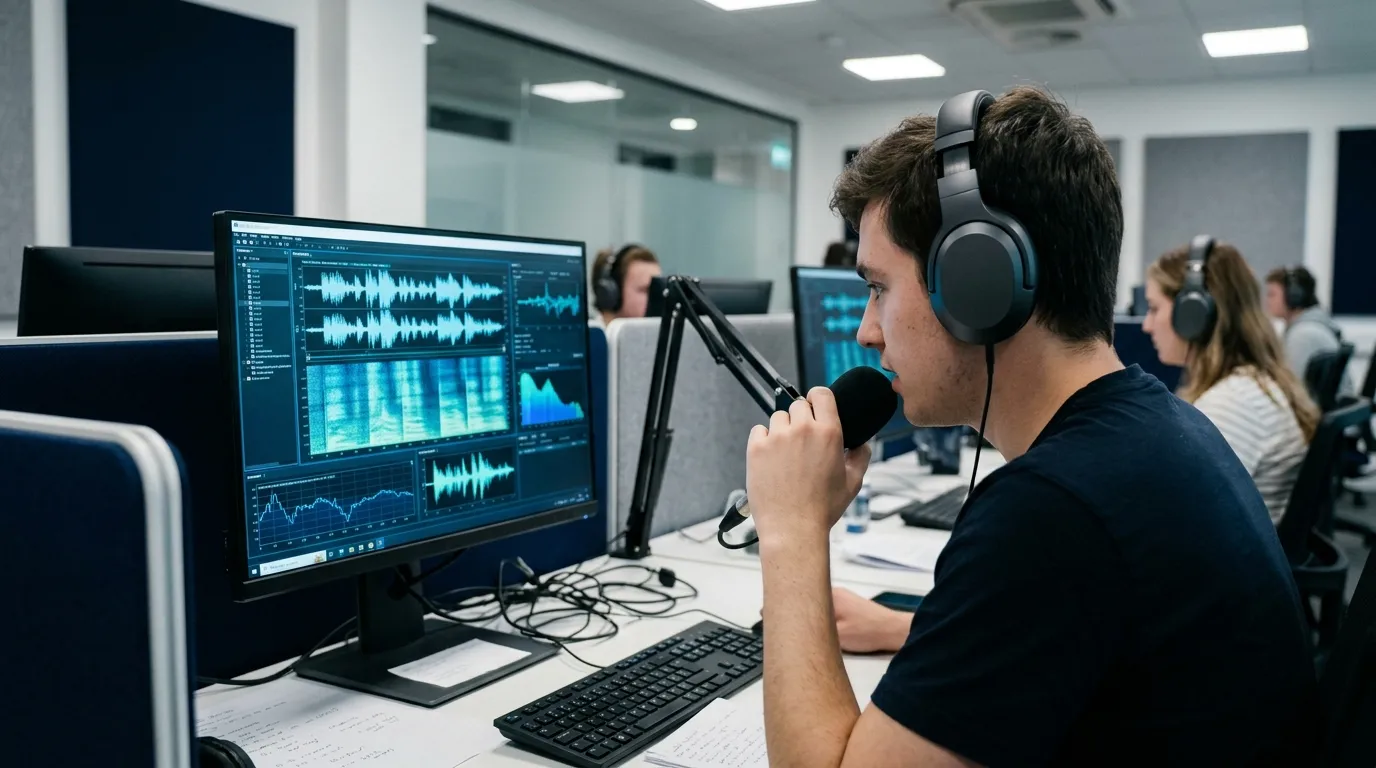
Langkah pertama dimulai dengan pengenalan suara otomatis (Automatic Speech Recognition). Teknologi ASR menerima input berupa sinyal audio analog yang ditangkap oleh mikrofons, kemudian memecahnya menjadi komponen frekuensi digital yang disebut spektrogram. Melalui model deep learning, sistem mengidentifikasi fonem (satuan bunyi bahasa terkecil) dan mengonversinya menjadi teks tertulis.
2. Neural Machine Translation (NMT)
Teks yang dihasilkan oleh ASR kemudian diproses oleh sistem Neural Machine Translation (NMT). Berbeda dari metode penerjemahan tradisional berbasis aturan (rule-based), NMT menggunakan jaringan saraf tiruan (neural network) berarsitektur Transformer. Model ini menganalisis seluruh kalimat secara simultan untuk memahami hubungan antar kata, idiom, dan tata bahasa berdasarkan konteks sebelum menghasilkan terjemahan dalam bahasa target.
3. Text-to-Speech (TTS)
Komponen terakhir adalah sintesis suara (Text-to-Speech). Setelah teks terjemahan terbentuk, model TTS mengonversi teks tersebut kembali menjadi gelombang audio. Teknologi TTS modern memanfaatkan model generatif untuk menghasilkan intonasi, penekanan, dan artikulasi yang menyerupai cara bicara manusia secara alami.
Perbandingan: Penerjemahan Berbasis Aturan vs Neural Machine Translation
| Parameter | Penerjemahan Berbasis Aturan (Rule-Based) | Neural Machine Translation (NMT) |
|---|---|---|
| Metode Pemrosesan | Kamus digital dan aturan tata bahasa kaku | Jaringan saraf tiruan berbasis konteks (Transformer) |
| Penerjemahan Konteks | Rendah (sering kali menerjemahkan kata demi kata) | Tinggi (memahami alur kalimat dan makna tersirat) |
| Penanganan Idiom | Sangat terbatas | Adaptif berdasarkan data pelatihani (training data) |
| Kecepatan Latensi | Cepat, tetapi hasil kaku | Membutuhkan komputasi tinggi, hasil lebih alami |
Implikasi dalam Dunia Pendidikan dan Pembelajaran Bahasa
Kehadiran fitur terjemahan suara langsung ini membuka peluang sekaligus tantangan baru dalam ekosistem pendidikan, khususnya pada pembelajaran bahasa asing dan literasi digital.
1. Alat Bantu Aksesibilitas dan Interaksi Inklusif
Teknologi ini memungkinkan pelajar dari berbagai latar belakang bahasa untuk berpartisipasi dalam diskusi kelas internasional atau mengakses materi pembelajaran global tanpa terkendala bahasa. Pelajar dapat mendengarkan materi dalam bahasa ibu mereka sembari mencocokkan teks bahasa aslinya.
2. Penguatan Pengucapan (Pronunciation Practice)
Modul ASR yang terdapat dalam aplikasi terjemahan dapat difungsikan sebagai alat evaluasi pengucapan. Ketika sistem ASR gagal mengenali kata yang diucapkan oleh siswa, hal tersebut memberikan umpan balik langsung bahwa artikulasi atau intonasi siswa perlu diperbaiki.
3. Transformasi Peran Pembelajaran Bahasa
Adanya terjemahan otomatis yang semakin akurat mengubah fokus pembelajaran bahasa. Pembelajaran tidak lagi sebatas hafalan kosakata atau aturan tata bahasa dasar, melainkan bergeser ke pemahaman budaya, analisis wacana kritis, serta kemampuan berkomunikasi tingkat tinggi yang membutuhkan nuansa emosional manusia.
Tantangan Teknis dan Keterbatasan
Meskipun sistem terjemahan real-time terus mengalami peningkatan akurasi, beberapa tantangan teknis masih menjadi batasan utama:
- Latensi Pemrosesan (Processing Latency): Pemrosesan tiga rantai teknologi (ASR, NMT, TTS) secara berurutan membutuhkan daya komputasi tinggi. Keterlambatan beberapa detik dapat mengganggu alur percakapan alami.
- Dialek dan Aksen Regional: Model ASR sering kali mengalami penurunan akurasi ketika berhadapan dengan aksen lokal, variasi dialek, atau gangguan latar belakang suara (background noise).
- Hilangnya Nuansa Budaya: NMT kerap kesulitan menerjemahkan kiasan, humor, atau ekspresi budaya yang tidak memiliki padanan langsung dalam bahasa lain.
Kesimpulan
Teknologi terjemahan suara real-time berbasis AI merupakan contoh penerapan ilmu komputer dan pemrosesan bahasa alami yang berdampak langsung pada komunikasi manusia. Dalam konteks pendidikan, teknologi ini hendaknya diposisikan sebagai alat bantu untuk mempercepat akses informasi dan latihan interaktif, bukan menggantikan proses berpikir kritis serta pemahaman mendalam tentang bahasa dan budaya.