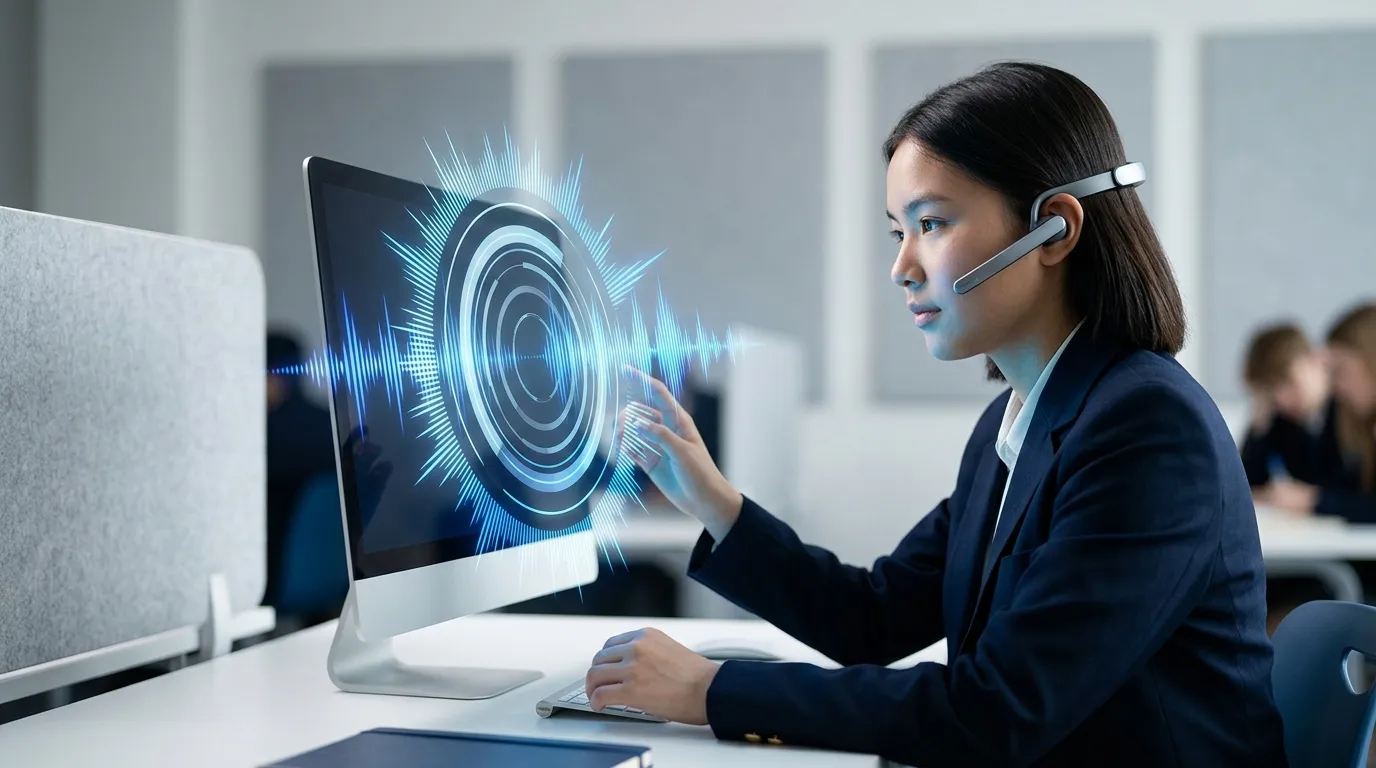
Selama beberapa dekade, laboratorium bahasa di sekolah dan universitas identik dengan deretan komputer, headset besar, dan perangkat lunak pemutar audio statis. Siswa mendengarkan rekaman, menirukan, dan merekam suara mereka sendiri tanpa ada yang memberikan evaluasi instan. Namun, memasuki akhir 2026, infrastruktur tradisional ini mulai ditinggalkan seiring dengan adopsi teknologi Multimodal Large Audio Model (Model Audio Besar Multimodal) ke dalam kurikulum bahasa asing.
Alih-alih berlatih menggunakan naskah kaku, siswa kini berhadapan dengan agen AI percakapan yang mampu merespons dalam hitungan milidetik. Sistem ini tidak sekadar mengenali kata, melainkan bertindak sebagai tutor privat yang mendeteksi nuansa nada, intonasi, dan emosi pengguna secara real-time.
Bagaimana Multimodal Audio AI Bekerja
Untuk memahami mengapa lompatan teknologi ini sangat penting bagi dunia pendidikan, kita perlu melihat perbedaan arsitektur AI generasi sebelumnya dengan model audio masa kini.
Pada asisten suara tradisional, proses komunikasi harus melewati tiga tahap (pipeline):
- Speech-to-Text (STT): Suara pengguna diubah menjadi teks.
- Text-to-Text (LLM): Teks tersebut diproses oleh AI untuk merumuskan jawaban tertulis.
- Text-to-Speech (TTS): Jawaban tertulis diubah kembali menjadi suara sintesis.
Proses tiga tahap ini memakan waktu (latensi tinggi) dan menghilangkan informasi non-verbal yang krusial dalam komunikasi manusia, seperti penekanan suku kata, keraguan (seperti jeda "ehm"), atau emosi.
Model terbaru, seperti pembaruan arsitektur pada OpenAI Advanced Voice atau Google Gemini Live, memangkas proses tersebut melalui pemrosesan audio end-to-end. Sistem mendengarkan input sebagai gelombang suara (spektrogram) dan langsung menghasilkan output berupa gelombang suara. AI tidak lagi "membaca" suara pengguna, melainkan "mendengarnya" secara harfiah. Hasilnya adalah latensi di bawah 300 milidetik—setara dengan kecepatan refleks percakapan manusia alami.
Analisis Akustik dan Umpan Balik Fonetik
Dalam konteks pendidikan, kemampuan pemrosesan audio langsung ini membuka dimensi baru yang disebut Analisis Fonetik Berbasis AI.
Ketika seorang siswa belajar bahasa dengan sistem nada yang kompleks, seperti bahasa Mandarin, kesalahan sedikit saja pada pitch (tinggi rendahnya nada) dapat merubah arti sebuah kata secara total. Guru manusia dalam kelas berisi 30 siswa kesulitan untuk mengoreksi nada setiap individu.
Dengan Model Audio AI, sistem menggunakan analisis akustik untuk membandingkan gelombang suara siswa dengan basis data fonetik penutur asli. Jika siswa salah mengucapkan nada, AI akan langsung memberikan umpan balik korektif yang sangat spesifik. Misalnya, AI tidak hanya mengatakan "Pengucapan Anda salah," tetapi akan memberikan instruksi motorik: "Nada Anda terlalu datar di akhir suku kata. Coba angkat bagian belakang lidah Anda dan naikkan intonasi di akhir kata seperti saat Anda bertanya."
Dari Menghafal Menuju Akuisisi Bahasa
Integrasi teknologi ini memicu pergeseran fundamental dalam teori pedagogi bahasa, dari Pembelajaran Bahasa (Language Learning) yang deduktif menuju Akuisisi Bahasa (Language Acquisition) yang induktif.
Secara tradisional, siswa belajar bahasa asing dengan menghafal rumus tata bahasa (deduktif). Pendekatan ini sering kali menghasilkan siswa yang jago menjawab soal ujian tertulis, tetapi gagap saat diajak berbicara.
Dengan kehadiran tutor AI audio, sekolah menerapkan metode imersi (induktif). Siswa didorong untuk langsung melakukan simulasi percakapan—misalnya simulasi negosiasi bisnis dalam bahasa Jepang atau memesan makanan di kafe Paris. AI akan menyesuaikan tingkat kerumitan kosakatanya berdasarkan level CEFR (Common European Framework of Reference for Languages) milik siswa. Sistem membiarkan siswa berbicara secara natural dan baru akan memberikan rangkuman perbaikan tata bahasa dan vocabulary setelah sesi simulasi selesai.
Ini membangun apa yang disebut oleh para ahli bahasa sebagai affective filter yang rendah. Siswa tidak merasa malu atau dihakimi saat membuat kesalahan pengucapan di depan mesin, sehingga kepercayaan diri (keberanian berbicara) meningkat secara drastis.
Kesimpulan
Kehadiran Multimodal Audio AI bukan sekadar alat penerjemah cerdas, melainkan inovasi pedagogis yang mendemokratisasi akses terhadap pengalaman imersi bahasa level penutur asli. Meskipun teknologi ini belum bisa sepenuhnya menggantikan empati dan pemahaman budaya yang mendalam dari seorang guru manusia, ia berfungsi sebagai mitra latihan yang tak kenal lelah. Di masa depan, pendidikan bahasa asing tidak lagi diukur dari seberapa banyak kosakata yang dihafal, melainkan seberapa luwes dan percaya diri siswa berkomunikasi dalam ekosistem global yang tanpa batas.